Nr. 4 (2026)
DOI: 10.5282/o-bib/6298
Die umfassende Digitalisierung von Gesellschaft und Wissenschaft hat die Menge und die Vielfalt wissenschaftlicher Informationsressourcen stark erhöht.1 Die Auffindbarkeit, Zugänglichkeit und Nachnutzbarkeit der digitalen Bestände von Bibliotheken, beispielsweise über Repositorien und Kataloge, ist eine wichtige Voraussetzung dafür, dass sie in Forschung und Lehre wahrgenommen und verwendet werden können. Klassifikationen sind dabei nach wie vor von großer Bedeutung, da sie Ressourcen fachlich einordnen, Zusammenhänge sichtbar machen und unterstützend bei explorativen Recherchen wirken.2 Wenn sie maschinenlesbar, mehrsprachig und über Schnittstellen (z. B. als Linked Open Data) angeboten werden, können sie besonders gut in Katalogen, Discovery-Systemen oder Repositorien genutzt werden.
Obwohl Klassifikationssysteme auf den ersten Blick veraltet und von neuen Technologien überholt erscheinen mögen, ergibt sich bei näherem Hinsehen ein anderes Bild: Suchmaschinen, Volltextindizes und Empfehlungssysteme strukturieren zwar die Informationssuche, eine fachliche Orientierung können sie jedoch nicht ersetzen. In der Wissenschaft ist es entscheidend, Informationen fachlich einzuordnen, ihre Vergleichbarkeit zu beurteilen und inhaltliche Zusammenhänge zu erkennen. Etablierte ein- oder mehrsprachige Klassifikationssysteme bieten stabile Strukturen, die im Unterschied zu rein textbasierten Suchverfahren nicht allein von Suchbegriffen, Sprachvarianten oder lokalen Erschließungstraditionen abhängen. Sie erleichtern die explorative Recherche, indem sie Ressourcen in ihrem fachlichen und systematischen Zusammenhang sichtbar machen.
Die Basisklassifikation (BK) bietet sich aus mehreren Gründen für eine Weiterentwicklung an: Eine englische Übersetzung der BK war seit Langem ein Desiderat der Community in Deutschland und Österreich, da sie ihre Sichtbarkeit und internationale Nachnutzung stärken würde. Sie ist offen nutzbar und kann leicht in unterschiedliche Anwendungen eingebunden werden. Zudem ist sie fachlich breit angelegt und somit für Bibliotheken, Verbünde, Repositorien und Discovery-Systeme geeignet. Darüber hinaus besitzt sie mit rund 2.000 Klassen eine mittlere Granularität: Sie ist differenziert genug für fachliche Aussagen, bleibt aber dennoch überschaubar. In Katalogen, Repositorien und Forschungsdatenkontexten kann sie als Facette, zur Navigation oder als semantischer Hinweis dienen. Außerdem ist eine große Anzahl von Titeln in mehreren Katalogen mit ihr erschlossen, hauptsächlich in den Bibliotheken des Gemeinsamen Bibliotheksverbunds (GBV) und des Österreichischen Bibliothekenverbunds (OBV), aber auch in weiteren Bibliotheken und Verbünden.
In letzter Zeit wurde die BK außerdem in mehreren Anwendungsszenarien zur Erschließung von Forschungsdaten (z. B. in der Registry des NFDI-Konsortiums Text+ oder im TextGrid Repository) eingesetzt.3 Durch ihre ausgewogene Granularität und leichte Handhabbarkeit lässt sich die BK für unterschiedlich tiefe Erschließungsanforderungen in verschiedenen technischen Umgebungen einsetzen.
Die internationale Nachnutzung der deutschen BK war bislang dadurch begrenzt, dass die Klassenbenennungen und weitere Felder ausschließlich auf Deutsch ausgedrückt vorlagen. Ohne englische Klassenbenennungen sinkt jedoch die Verständlichkeit und die Nachnutzbarkeit in multilingualen Kontexten und somit das Potenzial für internationale Projekte. Englisch fungiert in vielen Kontexten als Verkehrssprache. Eine englischsprachige BK würde die Einbindung in Datenflüsse, Discovery-Systeme, APIs, Linked Open Data und Terminologiedienste erleichtern. Mehrsprachigkeit ist eine strukturelle Qualität, die die flexible Verwendung in Oberflächen und Datenmodellen unterstützt. Die Übersetzung ist jedoch anspruchsvoll, da die Klassenbenennungen fachlich sehr präzise sind. Die englische Fassung muss sowohl die Semantik als auch die Terminologie sichern und dabei zugleich die Konsistenz der Benennungen innerhalb der gesamten Systematik gewährleisten.
Das BK-Übersetzungsprojekt knüpfte an bereits vorhandene Vorarbeiten an. Im institutionsübergreifenden fachlichen Austausch wurden mehrere englische BK-Versionen bekannt, unter anderem aus der Verbundzentrale des GBV (VZG), der Niedersächsischen Staats- und Universitätsbibliothek Göttingen (SUB Göttingen), der Staatsbibliothek zu Berlin und von Kolleg*innen aus Österreich. Dies zeigte, dass verschiedene Institutionen den Bedarf erkannt und sich damit befasst hatten. Diese Arbeiten waren jedoch parallel und teilweise mit nicht transparent dokumentierten Workflows sowie ohne eine durchgängige fachliche Überprüfung durchgeführt worden. Es fehlte eine konsolidierte, offizielle und in die Normsätze integrierte Fassung. Daraus ergab sich der Bedarf, vorhandene Übersetzungen zusammenzuführen, zu vergleichen und fachlich zu bewerten. 2024 griff die SUB Göttingen die Idee mit der VZG auf, und das Projekt wurde gemeinsam initiiert.
Die älteren Übersetzungen waren größtenteils automatisch generiert und nur teilweise intellektuell überprüft worden. Eine zentrale Herausforderung des Projekts bestand darin, einerseits die bereits vorhandenen Übersetzungen zu berücksichtigen und andererseits eine intellektuelle fachliche Überprüfung durch Expert*innen gezielt einzusetzen. Gerade kurze Klassenbenennungen sind häufig mehrdeutig. Automatische Übersetzungen erscheinen oft plausibel, erfassen aber nicht immer den systematischen oder terminologischen Kontext. Daher wurden die vorhandenen Fassungen gesammelt, weitere Vorschläge generiert und die Daten fachlich geprüft, wie in den nächsten Abschnitten beschrieben wird.
Das BK-Übersetzungsprojekt verfolgt vier zentrale Ziele: erstens eine konsolidierte Übersetzung, zweitens fachliche Qualität, drittens eine effiziente Arbeitsweise und viertens eine breite Nachnutzbarkeit.
Das erste Ziel ist eine einheitliche englische Übersetzung aller Klassenbenennungen. Dadurch soll eine verlässliche Fassung entstehen, die als offizieller Bezugspunkt in den Normsätzen dienen kann und nicht neben weiteren unkontrollierten Versionen steht. Eine solche Konsolidierung ist grundlegend für jede weitere technische und fachliche Verwendung.
Das zweite Ziel betrifft die fachliche Qualität. Die Übersetzung muss die Semantik der deutschen BK-Klassen erhalten und zugleich die Terminologie der englischsprachigen Wissenschaftscommunity berücksichtigen. Dies ist besonders wichtig, da Klassifikationsbenennungen häufig sehr unspezifisch sind und ihre Bedeutung erst aus dem systematischen Zusammenhang hervorgeht. Ein Beispiel dafür ist die BK-Klasse 11.45 mit der Klassenbenennung „Textkritik, historische Kritik”. Nur wenn berücksichtigt wird, dass die Klasse direkt von der Klasse 11.44 „Neues Testament” abhängt, wird deutlich, dass sich die Klasse 11.45 ausschließlich mit Textkritik zum Neuen Testament befasst. Eine fachlich angemessene Übersetzung muss daher mehr leisten als nur sprachliche Korrektheit. Sie muss inhaltlich passend, terminologisch etabliert und innerhalb der Systematik konsistent sein.
Das dritte Ziel ist Effizienz. Angesichts der Vielzahl möglicher Übersetzungsvarianten wäre eine rein manuelle Vorgehensweise aufwendig. Algorithmische Verfahren können hier Entlastung bieten, indem sie Vorschläge erzeugen, bestehende Varianten zusammenführen und Übereinstimmungen und Unterschiede quantifizieren und sichtbar machen. Die Entscheidung über die endgültige Benennung liegt jedoch bei den Expert*innen. Damit wird Effizienz nicht gegen Qualität ausgespielt, sondern als Voraussetzung verstanden, um fachliche Arbeit gezielt dort einzusetzen, wo sie den größten Mehrwert bietet.
Das vierte Ziel ist die Nachnutzbarkeit. Die englische BK soll nicht nur als interne Arbeitsdatei vorliegen, sondern auch in bestehende und zukünftige Informationsinfrastrukturen integriert werden. Dazu gehört das Vorliegen als Normsatz ebenso wie die Vorstellung der Daten auf Webseiten, APIs (z. B. als Linked Open Data) oder PDF-Bereitstellungen. Erst durch diese Bereitstellungsformen kann die Übersetzung ihre Wirkung in unterschiedlichen Anwendungen entfalten.
Zuerst wurde ein Auszug aller Felder aus den aktuellen deutschen BK-Normdaten im K10plus erstellt. Die ursprünglichen PICA-Daten wurden in eine Tabelle transformiert, in der jede Klasse eine neue Zeile und jedes PICA-Feld eine neue Spalte bildet Diese Tabelle war die Grundlage für alle weiteren Schritte bis zur Einspielung der Übersetzungen in den Normsatz der BK in K10plus und in DANTE, die Hostingplattform für Vokabulare (VZG).4
Zu dieser Tabelle wurden weitere Informationen hinzugefügt, die für das Projekt als wichtig erachtet wurden. Neben den Feldern der deutschen BK-Version wurden die Felder der niederländischen BK-Version (inklusive der englischen Übersetzung der Klassenbezeichnungen) sowie die Übersetzungen der deutschen BK aus der Staatsbibliothek zu Berlin und die 2022 mit einem Modell von Google automatisch generierte Version der VZG ergänzt. Darüber hinaus wurden weitere Informationen hinzugefügt, z. B. die Anzahl der bereits erschlossenen Titel im K10plus pro Klasse. Zudem wurde automatisch geprüft, ob die englische Wikipedia Einträge für die vorgeschlagene Übersetzung enthält und in diesen Fällen die dazugehörigen Wikipedia-Identifikatoren (Q-IDs) eingetragen.
Als nächstes wurden verschiedene neue Übersetzungsvorschläge pro Klasse generiert. Dazu wurde Ende 2024 die Python-Bibliothek „translators” benutzt, die mehrere Natural-Language-Processing-Übersetzungsdienste zur Verfügung stellt. Konkret wurden die Modelle von Google, DeepL und Bing genutzt. Die Eingaben dieser drei Modelle sowie die Übersetzung der VZG, die 2022 mit einem Google-Modell generiert wurde, wurden als die vier Vorschläge verstanden, die den Expert*innen zur Prüfung vorgelegt wurden. Diese vier Ergebnisse wurden miteinander verglichen, um zu berechnen, welcher Übersetzungsvorschlag pro Klasse die höchste Übereinstimmung zwischen den vier Modellen erhält. Dieser Vorschlag wurde als der beste ausgewählt. Dieser Vorschlag, sein Übereinstimmungswert und eine Auswahl von wenigen besonders wichtigen Spalten (Notation, Benennung auf Deutsch) wurden farblich markiert, um diese Informationen in der Tabelle für die Expert*innen leicht auffindbar zu machen. An dieser Stelle konnten die Personen sowohl zu ihrer konkreten Übersetzung als auch generell zur Klasse Kommentare abgeben, beispielsweise dazu, ob sie die Klasse inhaltlich als veraltet betrachten.
Man könnte sich fragen, warum nicht mit moderneren Modellen wie Large Language Models (LLM) gearbeitet wurde. Tests haben aber gezeigt, dass die Ergebnisse nicht besser als die der NLP-Tools waren. Darüber hinaus eignen sich LLMs besonders gut für Aufgaben, die mehrere Aufgaben kombinieren, was die Modelle aus vorherigen Generationen nicht so gut konnten. Da die Aufgabe sehr spezifisch war und seit Jahrzehnten zu den etablierten Aufgaben des NLP gehört, wurde entschieden, diese Tools anzuwenden. Darüber hinaus ist die Anwendung kleinerer, spezifischer Modelle ein Aspekt der ethischen Verwendung maschinellen Lernens und künstlicher Intelligenz in Bibliotheken.5
Bevor die Aufgabe der Überprüfung an die Expert*innen weitergegeben wurde, wurden gemeinsam mit dem Fachinformationsdienst Anglo-American Culture (FID AAC)6 Übersetzungsrichtlinien mit Beispielen entwickelt. Darin wurde explizit klargestellt, dass bei Klassenbenennungen, die auf Deutsch mittlerweile veraltet klingen, die Übersetzungen nicht versuchen sollten, die Klassen zu modernisieren, denn diese Modernisierung wird im Rahmen des Projekts zur Überarbeitung der BK (BK-Relaunch) geleistet.7 In den Richtlinien wurde festgehalten, dass der britischen Variante gegenüber anderen Schreibvarianten der Vorzug gegeben wird und es wurden einheitliche Übersetzungen für Formulierungen festgelegt, die sich in vielen Hauptklassen wiederholen (wie z. B. „Allgemeines“ oder „Philosophie und Theorie der ...“).
Nach mehreren Beta-Tests wurde die Tabelle, in der die Fachexpert*innen arbeiten, hinsichtlich der Benutzer*innenfreundlichkeit optimiert. Die neue Arbeitsweise wurde den Expert*innen in digitalen Treffen erklärt. Im Herbst 2024 und Winter 2024/2025 wurde aktiv nach Ansprechpersonen für die Hauptklassen gesucht. Von Anfang an spielten die FID eine wesentliche Rolle im Projekt: Der FID AAC half bei der Rekrutierung, und viele der Expert*innen kamen aus anderen FID. Die schnelle Durchführung des Projekts ist auch ein Beleg für die gute Vernetzung der FID untereinander.8 Andere Personen im Team arbeiteten in NFDI-Konsortien oder als Fachreferent*innen. Kolleg*innen aus den folgenden Institutionen konnten für die Mitarbeit gewonnen werden:9
Verbundzentrale des GBV (Göttingen)
SUB Göttingen
Herzog August Bibliothek (Wolfenbüttel)
Humboldt-Universität zu Berlin
SUUB Bremen
ZBW – Leibniz-Informationszentrum Wirtschaft (Kiel und Hamburg)
TIB – Leibniz-Informationszentrum Technik und Naturwissenschaften und Universitätsbibliothek (Hannover)
SLUB Dresden
Universität Heidelberg
Staatsbibliothek zu Berlin
Technische Universität Braunschweig
Österreichischer Bibliothekenverbund
ZB MED – Informationszentrum Lebenswissenschaften (Köln)
Universität Halle
Universität Münster
Universität Tübingen
Universität zu Köln
Universität Leipzig
DIPF – Leibniz-Institut für Bildungsforschung und Bildungsinformation (Frankfurt am Main)
ZPID – Leibniz-Institut für Psychologie (Trier)
Deutsche Gesellschaft für Philosophie (Leipzig)
Akademie der Wissenschaften und der Literatur | Mainz
Bayerische Staatsbibliothek (München)
Insgesamt waren 44 Fachexpert*innen von Januar bis Mai 2025 beteiligt, von denen die Mehrheit eine Hauptklasse überprüft hat. Durchschnittlich betreute jede Person ca. 50 Klassen, sodass der Aufwand für alle Beteiligten gering blieb und innerhalb ihrer jeweiligen Expertise lag. Die Autor*ìnnen bedanken sich herzlich bei allen, die sich beteiligt haben. Ohne diese gemeinsame Arbeit hätte das Projekt nicht durchgeführt werden können.
Die beschriebene Arbeitsweise ermöglichte es, die Ergebnisse der NLP-Modelle mit den finalen Entscheidungen der Expert*innen abzugleichen, sodass das Verfahren mit Blick auf drei Fragen evaluiert werden konnte. Die erste Frage lautete, ob die Expert*innen den zuvor ermittelten besten Vorschlag angenommen haben. Bei dieser und den weiteren Fragen wurden kleine Änderungen wie z. B. Groß- und Kleinschreibung nicht berücksichtigt.
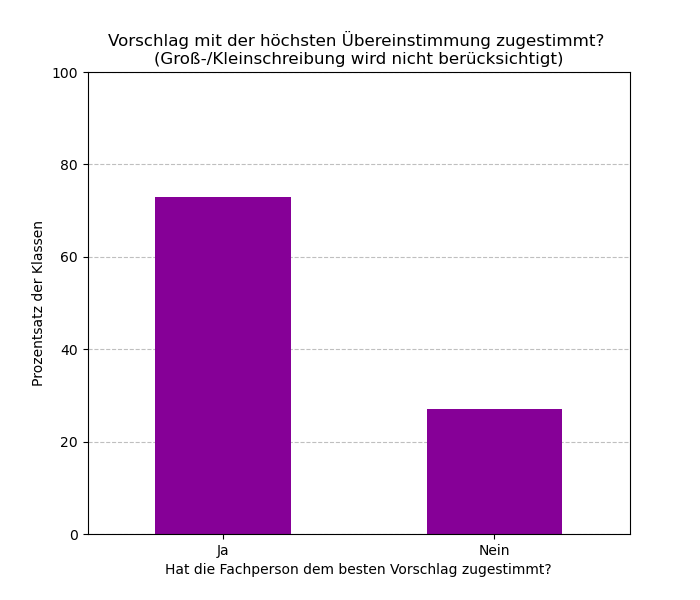
Wie Abbildung 1 zeigt, wurde in 73 % der Fälle der beste Vorschlag der Algorithmen angenommen, in 27 % wurde eine andere Variante als endgültige Übersetzung ausgesucht. Die gewählte Arbeitsweise hat sich also bewährt, denn die Algorithmen haben in der Mehrheit der Fälle sinnvolle Vorschläge geliefert, hätten aber ohne menschliche Überprüfung zu einem deutlich anderen Ergebnis geführt.
Die nächste Frage lautete, ob es ausgereicht hätte, die Übersetzung der niederländischen BK (NBK) oder die der Staatsbibliothek zu Berlin zu verwenden. Abbildung 2 zeigt den Vergleich zwischen der endgültigen Übersetzung und diesen beiden bereits vorher existierenden Übersetzungen.
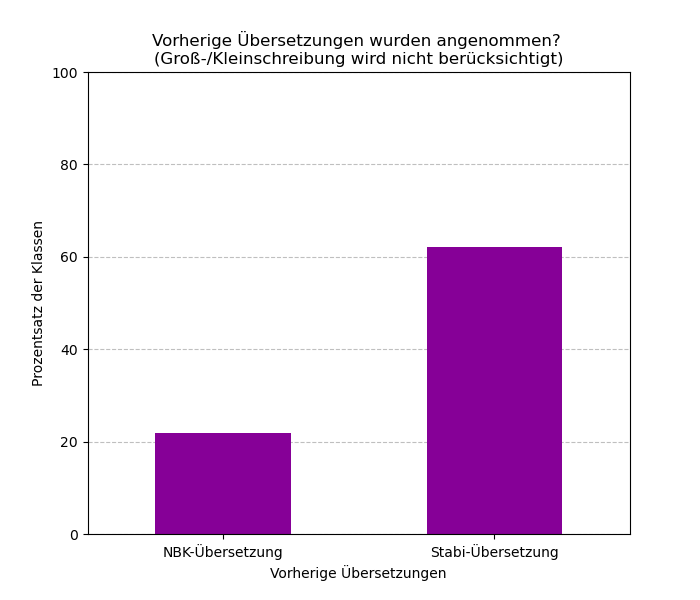
In 62 % der Fälle ist die Übersetzung der Staatsbibliothek zu Berlin identisch mit der neuen. Es muss jedoch angemerkt werden, dass es einen wesentlichen Unterschied zwischen dieser Übersetzung und der neu erstellten gibt: Die Staatsbibliothek zu Berlin hat sich für die amerikanische Schreibvariante entschieden, während die Übersetzung dieses Projektes die britische Variante favorisiert. Im Fall der NBK sind nur ca. 22 % der Übersetzungen identisch. Das zeigt, dass die niederländische und die deutsche Version der BK mittlerweile grundsätzlich unterschiedliche Klassifikationssysteme sind, die nicht mehr kompatibel sind. Ähnlich wie bei den Ergebnissen in Abbildung 1 zeigt diese Auswertung, dass es sinnvoll war, eine komplett neue Übersetzung zu erstellen.
Die letzte Frage betrifft den Algorithmus, der nach der Entscheidung unserer Fachexpert*innen die besten Ergebnisse geliefert hat. Dazu wurden die Ergebnisse der vier Algorithmen mit der Entscheidung der Fachexpert*innen verglichen.
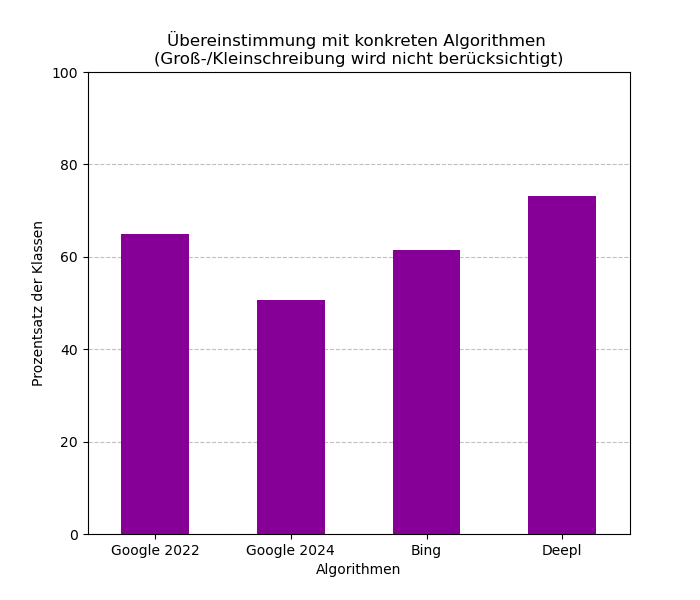
Wie Abbildung 3 zeigt, schwanken die Ergebnisse zwischen 50 % und 73 %. Es ist interessant, dass die Verwendung des Google-Modells in zwei verschiedenen Jahren nicht nur unterschiedliche Ergebnisse geliefert hat, sondern auch eine deutliche Verschlechterung zu beobachten ist. Sowohl Google 2022 als auch Bing erreichen knapp über 60 % der Fälle, während DeepL einen deutlichen Vorsprung mit 73 % erzielt. Beim Vergleich dieser Daten mit den Ergebnissen von Abbildung 1 zeigt sich: Das Modell von DeepL hat im Grunde genommen den gleichen Wert wie der Vorschlag mit der höchsten Übereinstimmung erreicht.
Bis Anfang Juni 2025 prüften die Fachexpert*innen die Klassen. Während des Sommers wurden verschiedene Aspekte wie beispielsweise Interpunktion und Schreibweise vereinheitlicht sowie die Homogenität wiederkehrender Formulierungen geprüft.
Vor der Einspielung der Daten in den K10plus wurden diese noch einmal nach formellen Kriterien geprüft. Dabei wurde eine neue Spalte mit der endgültigen Übersetzung erzeugt.10 Da die Tabellen auch die Identnummer des jeweiligen Normsatzes (PPN) enthalten, konnte die Einspielung der Übersetzungen in die Normsätze im K10plus automatisch stattfinden, nachdem die Daten in DANTE importiert worden waren. Seitdem stehen die Übersetzungen auch in den Online-Registern von Vokabularen wie BARTOC,11 VZG Terminology12 und dem Mapping-Tool Cocoda13 zur Verfügung und können außerdem von weiteren Ressourcen wie OPACs, Discovery-Systemen oder Repositorien genutzt werden.
In diesem Praxisbericht wurde gezeigt, wie innerhalb von etwa einem Jahr ein lang ersehntes Ziel erreicht wurde: eine konsolidierte, intellektuell geprüfte Übersetzung der deutschen BK. Dafür wurden sowohl die Fachexpertise vieler Kolleg*innen in verschiedenen Institutionen und Projekten als auch die Schnelligkeit und der Output von Programmen des maschinellen Lernens genutzt. Das zeigt, dass eine sinnvolle Kombination aus computergestützten und qualitativen Ansätzen in vielen bibliothekarischen Kontexten die beste Arbeitsweise darstellt.
Dieses Projekt ist Teil einer neuen Phase für die BK.14 Nach vielen Jahren als „Stiefkind“ der Klassifikationssysteme erlebt sie mit den zwei Projekten und der Erweiterung ihrer Nutzung eine Renaissance. Ein weiteres wichtiges Projekt ist der Relaunch der BK, bei dem viele Aspekte geändert werden: Bei dieser Überarbeitung werden u. a. an vielen Stellen die Klassenbenennungen geändert und teilweise auch neue Klassen eingeführt. Diese Neuerungen bringen neue Herausforderungen mit sich, z. B. die Versionierung des Systems, die Anpassung der Daten in Katalogen und auf weiteren Plattformen sowie die Aktualisierung dieser Daten. Die aktuelle Version der deutschen BK, mit der die Bibliotheken viele Jahre gearbeitet haben, ist als BK 1.0 zu verstehen. Mit dem Projekt kann festgehalten werden, dass die Klassenbenennungen aller Klassen der deutschen BK 1.0 übersetzt sind. Bei den folgenden Versionen der BK (BK 1.1 bzw. BK 2.0) sollten die jetzigen Übersetzungen der Klassen entsprechend angepasst werden. Darüber hinaus soll an dieser Stelle betont werden, dass im Rahmen des Projekts lediglich ein Feld – nämlich die Klassenbenennung – in eine andere Sprache übersetzt wurde. Von verschiedenen Institutionen und Projekten wurde bereits Interesse daran bekundet, einerseits andere Felder der BK (also z. B. auch Erläuterungen und Verweisungen) ins Englische zu übersetzen und andererseits weitere Sprachen zu berücksichtigen. Für diese oder weitere vergleichbare Vorhaben kann der hier beschriebene Ansatz zur Umsetzung eines kooperativen Projekts hoffentlich als Modell dienen.
o-bib Das offene Bibliotheksjournal
ISSN: 2363-9814